Alucinaciones: el error que Turing dejó a propósito
Premiamos al que finge saber y después nos sorprendemos de que finja. La IA alucina por razones que la investigación ya empieza a explicar, y la primera pista la dejó Turing en 1950 con una suma mal hecha. Por Alicia Bañuelos
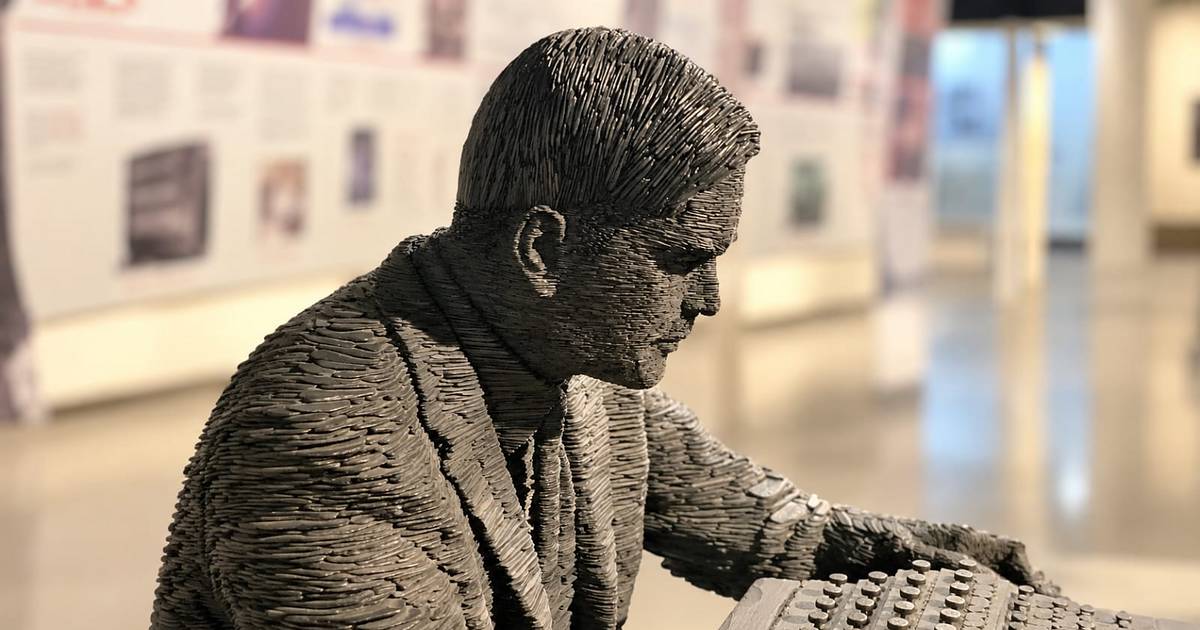
Alan Turing fue un matemático británico, nacido en 1912, al que se considera uno de los padres de la informática. En 1936 describió la "máquina de Turing", el modelo teórico sobre el que se construyeron las computadoras modernas.
Durante la Segunda Guerra Mundial diseñó una de las máquinas que ayudaron a descifrar los mensajes de Enigma, el sistema de cifrado de la Alemania nazi, un trabajo del que se suele decir que acortó la guerra en al menos dos años.
En 1952 fue condenado en su país por ser homosexual, algo que entonces era delito, y murió en 1954, a los 41 años. Hoy su nombre lleva el máximo premio de la informática, algo así como su Nobel.
En 1950 publicó el artículo que abrió la discusión sobre si las máquinas piensan. Para explicar su "juego de la imitación" incluyó un diálogo de ejemplo. Pregunta: sume 34957 y 70764. Respuesta de la máquina, después de una pausa de unos treinta segundos: 105621.
La cuenta está mal. El resultado correcto es 105721. La máquina más célebre de la historia del pensamiento se equivoca en una suma de cinco cifras y, de yapa, se toma medio minuto para hacerlo, como quien se concentra.
¿Fue un descuido de uno de los matemáticos más grandes del siglo XX? Es improbable. El artículo no lo aclara, así que cualquier explicación es una interpretación, pero la más difundida es que fue un guiño deliberado: para pasar por humana, una máquina tiene que fallar de vez en cuando, y tardar, como una persona. En los últimos días el número 105621 volvió a circular en redes como una especie de profecía. Setenta y seis años después, las máquinas aprendieron la lección, quizás demasiado bien.
Conviene empezar por la palabra. "Alucinación" es una metáfora imperfecta: quien alucina percibe algo que no está, y un modelo de lenguaje no percibe nada. Lo que hace es completar con lo más plausible, y a veces lo plausible es falso. Hubo propuestas de cambiarla, entre ellas "confabulación", un término de la psiquiatría que se planteó en 2023 y que el organismo de estándares de Estados Unidos (NIST) usa como nombre oficial de este riesgo en una guía de 2024. Ninguna terminó de imponerse, y cada una arrastra sus propias comparaciones con la mente humana. Los autores del trabajo que voy a citar reconocen que el fenómeno difiere de la experiencia perceptiva humana. Usaré "alucinación" porque es la palabra que todos entienden, sin que eso la vuelva exacta.
¿Y por qué pasa? Un artículo de septiembre de 2025, de investigadores de OpenAI y Georgia Tech, sostiene que no hay misterio. El origen está en el preentrenamiento, cuando el modelo aprende la distribución del lenguaje a partir de un corpus gigantesco. Hay cosas que se aprenden bien porque tienen un patrón, como la ortografía o la gramática. Y hay otras que no tienen ningún patrón que aprender. El cumpleaños de una persona poco conocida es un dato arbitrario: o lo viste o no lo viste. Cuando le preguntaron a tres modelos populares por el título de la tesis doctoral de uno de los autores, ninguno acertó el título ni el año.
La cuenta es casi una regla de tres. Para esos datos arbitrarios, la tasa de error de un modelo base es al menos la fracción de hechos que aparecieron una sola vez en el entrenamiento. Si el 20% de los cumpleaños figura exactamente una vez, hay que esperar que el modelo falle en al menos el 20%. La fecha de Einstein no es problema, porque aparece mil veces. La de alguien que salió en una sola nota necrológica, sí.
Y acá viene la ironía. La herramienta matemática detrás de esa cuenta es el estimador de "masa faltante" de Turing, publicado por Good en 1953, que usa la fracción de cosas vistas una sola vez para estimar cuánta probabilidad queda para lo que todavía no apareció. Turing, otra vez.
El segundo origen no está en la estadística sino en el aula. Después del preentrenamiento, el modelo pasa por una etapa de ajuste para volverlo útil y menos propenso a decir disparates. Pero ese ajuste se mide con exámenes, y los exámenes tienen un defecto que conocemos desde la secundaria: si equivocarse no cuesta nada, conviene contestar siempre. Dejar en blanco da cero puntos. Arriesgar, aunque sea a ciegas, da cero o uno.
Los autores lo dicen sin vueltas: los modelos están siempre en modo rendir examen. Imaginemos dos alumnos. El A es honesto y escribe "no sé" cuando no sabe. El B nunca duda y adivina todo. Con la puntuación habitual, el B saca mejor nota. De las diez evaluaciones influyentes que analizaron, entre ellas GPQA, MMLU-Pro y SWE-bench, sólo una da algún crédito, mínimo, por reconocer incertidumbre. En las otras nueve, el "no sé" puntúa igual que un error.
No es entonces un defecto escondido en la arquitectura. Es un incentivo. Para entenderlo hay que saber cómo se califica a un modelo: se le hacen miles de preguntas y se le da un punto por cada acierto y cero por cada error o cada "no sé". Con esa regla, a la máquina le conviene siempre responder algo, porque lo peor que le puede pasar es sacar lo mismo que si hubiera admitido que no sabía. Nadie le enseñó a engañar. Aprendió lo que el sistema premia. Premiamos al que finge saber y después nos sorprendemos de que finja.
El tercer origen es el más fascinante, porque por primera vez alguien pudo mirar adentro. En 2025, investigadores de Anthropic presentaron una técnica para trazar los circuitos internos de un modelo, algo así como un microscopio, y la probaron en Claude 3.5 Haiku. Encontraron que, por defecto, el modelo está inclinado a no especular: ante una pregunta, el circuito del "no puedo responder" arranca encendido.
Lo que lo apaga es el reconocimiento. Cuando el modelo identifica una entidad conocida, se activan rasgos del tipo "esto lo sé" que inhiben esa negativa y lo dejan hablar. Si el nombre le es completamente ajeno, declina. Hasta acá, funciona como debería.
El problema aparece cuando el reconocimiento falla a medias. Si el nombre le suena pero no sabe nada concreto, el circuito de la familiaridad apaga igual la reticencia y el modelo se larga a rellenar. Según el trabajo, activando artificialmente esos rasgos se puede inducir a un modelo a inventar una respuesta sobre un nombre inexistente. No inventa porque ignore, sino porque cree reconocer. Se parece a lo que nos pasa cuando saludamos con entusiasmo a alguien cuyo nombre no recordamos. Los autores aclaran que el método captura sólo una fracción de lo que pasa adentro, así que conviene tomarlo como una primera mirada y no como un diagnóstico definitivo.
¿Se puede arreglar? Los autores del artículo de OpenAI creen que sí, y su propuesta es casi escolar: que cada examen diga la regla. Por ejemplo, "respondé sólo si estás más de un 75% seguro, porque cada error resta dos puntos". Algunas pruebas humanas, como el SAT (el examen de ingreso a las universidades de Estados Unidos) o el GRE (el que se rinde para entrar a un posgrado), ya penalizaban los errores en versiones anteriores. El detalle importante es que el cambio tiene que ocurrir en las evaluaciones que dominan los rankings, y no en una más que se agregue al montón. Es un problema técnico, pero también de incentivos de toda una industria.
Mientras tanto, la lógica del estudio deja una pista práctica. El riesgo se concentra en lo raro: nombres poco difundidos, fechas exactas, citas bibliográficas, datos locales. Es de esperar que un modelo acierte la fecha de Einstein y falle la de mi prima Ely, que figura una sola vez en internet, en un comentario de Facebook de 2014. Cuanto más específico y menos documentado el dato, más motivo para verificarlo.
Turing hizo que su máquina se equivocara para parecer humana. Nosotros terminamos con máquinas que se equivocan con una seguridad que ninguna persona sensata exhibiría, porque les enseñamos que decir "no sé" es sacarse cero. Quizás la lección de 105621 no sea que las máquinas deban fallar, sino que deberían poder reconocer cuándo.
Temas de nota:
Más Noticias
Fuente: El Diario de la República
- #tecnologia
- #2026
- #alucinaciones
- #error
- #que
- #turing
- #dejo
- #proposito
- #san luis